School of SRE
最近在准备工作相关的,感觉 SRE 是个重要方向,所以开始看 Linkedin 的 SRE 教程,纯英,看的有点吃力,所以一边看一边写笔记缓解一下。这份笔记是我的个人评论和部分原文的 GPT5.6 sol翻译的结合,主要融入了一些我查阅的关于教程中我不理解的地方的信息,当否供参考。Linkedin 的 SRE 教程原链接 https://linkedin.github.io/school-of-sre/,此份文档遵循CC BY-NC-SA 4.0 协议。
School of SRE
站点可靠性工程师(Site Reliability Engineer,SRE)处于软件工程与系统工程的交叉领域。虽然基础设施和软件组件的组合方式几乎是无限的,不同组件可以通过各种排列组合来实现特定目标,但只要掌握扎实的基础技能,SRE 就能够应对复杂的系统和软件,不必过分依赖具体技术环境——无论这些系统是企业自研的、第三方提供的、开放式系统,还是运行在云端或本地基础设施上。关键是要深入理解系统与基础设施中各个领域之间是如何相互关联、相互作用的。兼具软件工程和系统工程能力的人才相对少见,这类能力通常需要经过较长时间的积累,并通过接触各种不同类型的基础设施、系统和软件逐渐形成。
SRE 会将工程化实践引入系统运维工作,以确保网站和服务能够持续稳定运行。每一个分布式系统本质上都是由大量组件组合而成的。SRE 需要验证业务需求,并将这些需求转化为针对分布式系统各个组成部分的服务等级协议(Service Level Agreement,SLA);持续监控和衡量系统是否满足这些 SLA。当系统存在违反 SLA 的风险时,SRE 会通过重新设计系统架构、横向扩展等方式进行缓解或避免。与此同时,SRE 还会把这些实践中获得的经验反馈到新的系统或项目中,从而减少日常运维中重复、繁琐的人工工作(operational toil)。因此,在系统设计之初(day 0),SRE 就发挥着非常重要的作用。
我们相信,持续学习能够帮助大家获得更深入的知识和能力,从而不断扩展自己的技能体系。因此,每个模块中都加入了相关参考资料,可作为进一步学习的指南。我们希望,通过学习这些模块,大家能够逐步具备一名 SRE 所必需的核心技能。
Level 101
101 是美国大学课程编号里的习惯用法,通常代表某领域的基础课,201 301 401依次进阶。后文的 102 通常是 101 下一门课的编号。
什么是 Linux 操作系统
我们大多数人都比较熟悉 Windows 操作系统。在个人电脑中,Windows 的使用比例超过 75%。Windows 操作系统基于 Windows NT 内核。
所谓内核(kernel),是操作系统中最重要的组成部分。它负责执行很多核心功能,例如进程管理、内存管理、文件系统管理等。
Linux 操作系统则基于 Linux 内核。一个基于 Linux 的操作系统通常包括 Linux 内核、GUI/CLI、系统库以及系统工具。Linux 内核最初由 Linus Torvalds 独立开发并发布。Linux 内核是自由且开源的软件。
Linux 本身严格来说只是一个内核,并不是一个完整的操作系统。Linux 内核通常会与 GNU 系统结合,组成一个完整的操作系统。因此,基于 Linux 的操作系统也常被称为 GNU/Linux 系统。
GNU 是一个非常庞大的自由软件集合,其中包括编译器、调试器、C 语言库等工具和组件。
关于 Linux 与 GNU 系统之间的关系,可以参考: Linux and the GNU System
关于 Linux 的发展历史,可以参考: History of Linux
什么是常见的 Linux 发行版
Linux 发行版(Linux distribution,简称 distro)是基于 Linux 内核,并配套了一套软件包管理系统的操作系统。
所谓软件包管理系统(package management system),是由一组用于安装、升级、配置和卸载操作系统中软件的工具组成的。
软件通常需要针对不同的 Linux 发行版进行适配,并被打包成该发行版所采用的特定格式。这些软件包一般会存放在对应发行版的软件仓库(repository)中。
在操作系统中,用户通过**软件包管理器(package manager)**来安装和管理这些软件包。
常见的 Linux 发行版包括:
- Fedora
- Ubuntu
- Debian
- CentOS
- Red Hat Enterprise Linux(RHEL)
- SUSE
- Arch Linux
不同发行版通常采用不同的软件包格式和软件包管理器:
| 软件包体系 | 常见发行版 | 软件包管理器 |
|---|---|---|
Debian 系(.deb) | Debian、Ubuntu | APT |
Red Hat 系(.rpm) | Fedora、CentOS、Red Hat Enterprise Linux | YUM |
以上内容已经老了,2019 年 YUM 底层就彻底被 DNF 替代了,近几年 Nix 也火了:
软件包体系 常见发行版 软件包管理器 Debian 系( .deb)Debian、Ubuntu APT Red Hat 系( .rpm)Fedora、CentOS Stream、Red Hat Enterprise Linux DNF SUSE 系( .rpm)openSUSE、SUSE Linux Enterprise Zypper Arch 系( .pkg.tar.zst)Arch Linux、Manjaro Pacman Nix 系 NixOS Nix
Linux 架构
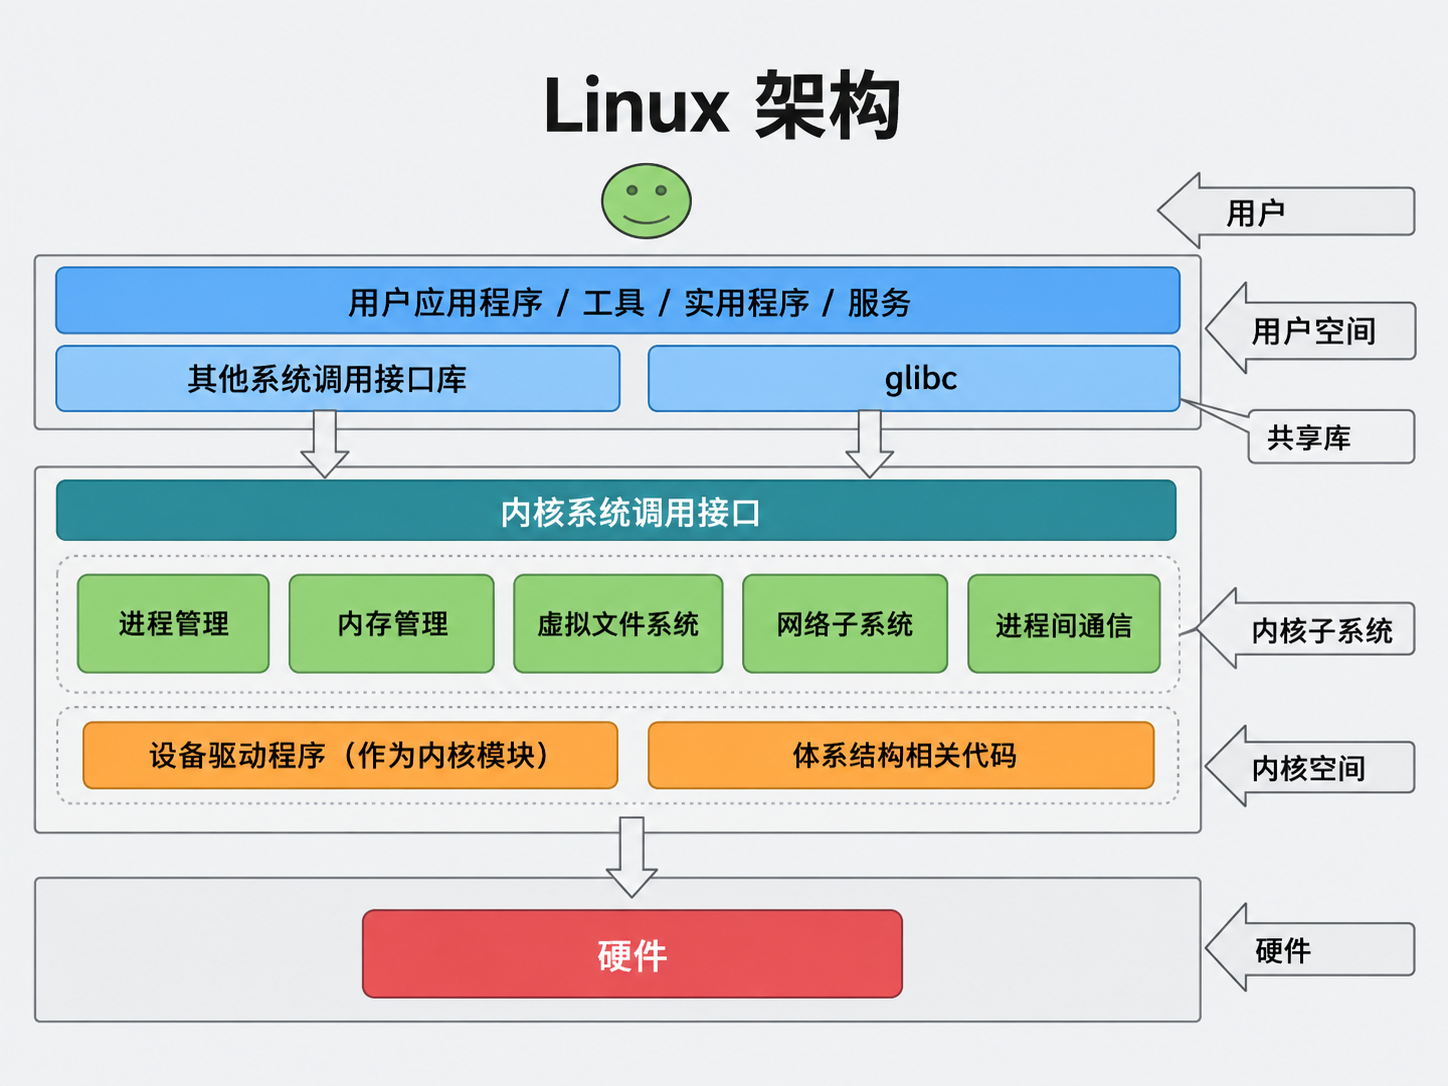
图中用户空间运行普通程序,例如 ls。大多数应用程序都运行在这一层,它们通常会依赖 glibc 或其他用户态库提供的接口。程序需要内核服务时,会通过系统调用接口发起请求,此时 CPU 从用户态切换到内核态,由内核中的不同子系统处理相应功能。进程管理负责进程的创建、调度和结束;内存管理负责虚拟内存、内存分配和页表等;虚拟文件系统 VFS 负责统一抽象不同文件系统;网络子系统负责 TCP/IP、socket 等网络功能;进程间通信 IPC 负责不同进程之间的数据交换。设备驱动则负责内核与具体硬件之间的通信,最终完成硬件操作。
- Linux 内核本质上采用**宏内核(Monolithic Kernel)**架构。
宏内核是指大多数核心功能(文件系统、驱动等)都直接放到内核里运行的架构,区别于微内核——只保留核心功能。
- 内核代码只能在内核态(Kernel Mode)下执行;非内核代码通常运行在用户态(User Mode)。
用户态是供普通程序运行的低权限 CPU 执行模式,不能直接访问内核内存和随意操作硬件,内核态则是高权限 CPU 执行模式,可以访问系统全部内存和硬件资源。这里的权限指的是执行时 CPU 有多高的硬件权限,和操作系统的访问控制规则不同层级。
- 用户空间程序通过**系统调用(System Call)**与 Linux 内核空间进行交互。
系统调用运行在用户态的程序,为了请求操作系统内核提供某项受保护的服务,而通过规定接口主动切换到内核态执行的一种机制。用户态的程序像读写文件,建立网络连接都得请求内核服务,发生从用户态->内核态->用户态的切换。
- **设备驱动(Device Driver)**用于与硬件设备进行通信。
Linux 操作系统的用途
基于 Linux 内核的操作系统被广泛应用于:个人电脑,服务器,手机:Android 基于 Linux 内核;嵌入式设备:如手表、电视、交通信号灯等;卫星,网络设备:如路由器、交换机等。
图形用户界面(GUI)与命令行界面(CLI)
用户借助用户界面(User Interface)与计算机进行交互。用户界面可以是 GUI(Graph User Interface),也可以是 CLI(Command Line Interface)。
GUI 允许用户通过图标、图像等图形元素与计算机进行交互。当用户点击某个图标来打开计算机上的应用程序时,实际上就是在使用 GUI。使用 GUI 执行任务通常比较容易。
CLI 允许用户通过命令与计算机进行交互。用户在终端中输入命令,系统负责执行这些命令。对于习惯使用 GUI 的新用户来说,CLI 可能会比较难,因为用户需要知道执行某项具体操作所对应的命令。
Shell 与终端
Shell 是一种程序,它接收用户输入的命令,并将这些命令交给操作系统处理。Shell 是 CLI 的一种实现。Bash 是 Linux 服务器上最常见的 Shell 程序之一。其他常见的 Shell 程序还有 zsh、ksh、tcsh、fish、dash、nushell等等。
终端(Terminal)是一种程序,它会打开一个窗口,并允许你与 Shell 进行交互。常见的终端程序包括 GNOME Terminal、xterm、Konsole、Kitty等。
Linux 用户经常会将 shell、终端、命令提示符、控制台等术语混用。简单来说,这些术语都可以用来指代一种接收用户命令的方式。
命令行基础
命令是什么
命令(command)是一个告诉操作系统执行某项特定工作的程序。在 Linux 中,程序以文件的形式存储。因此,一个命令本质上也是一个存放在磁盘某处的文件。
大多数常见 Linux 命令,本质上都是用户空间程序(还有一些 Shell 内置命令),并不是 Linux 内核的一部分,因此理论上可以不安装。下面这些命令只是大多数发行版通常会预装的工具。
命令还可以接收用户提供的额外参数作为输入,这些参数称为命令行参数(command-line arguments)。
了解如何使用命令很重要,而 Linux 提供了很多获取帮助的方法,尤其是针对各种命令。几乎每个命令都会提供某种形式的文档。大多数命令都支持 -h 或 –help 这样的命令行参数,用来显示一定量的帮助信息。
不过,Linux 中最常用的文档系统是 man pages,也就是 manual pages(手册页) 的简称。
文件系统组织方式
Linux 文件系统采用树状结构,其最高层级的目录称为根目录(root directory),用 / 表示。根目录下包含多个目录,用于存放与系统相关的文件。这些目录中又可以继续存放系统文件、应用程序文件或与用户相关的文件。
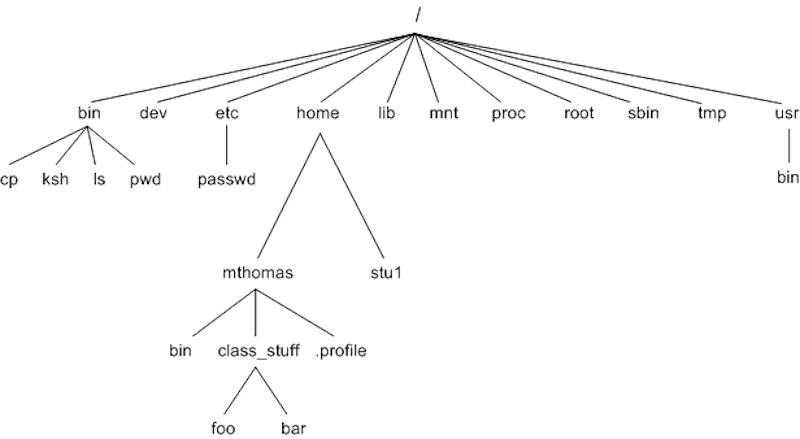
| 目录 | 英文来源 | 说明 |
|---|---|---|
/bin | binary | 存放最常用命令的可执行程序 |
/dev | device | 存放与系统设备相关的文件 |
/etc | et cetera | 存放系统配置文件 |
/home | home | 存放普通用户的文件和目录 |
/lib | library | 存放系统所需的库文件 |
/mnt | mount | 通常用于挂载设备或文件系统 |
/proc | process | 存放与当前运行进程和内核状态相关的虚拟文件 |
/root | root | root 用户的主目录 |
/sbin | system binary | 存放系统管理相关的程序 |
/tmp | temporary | 存放临时文件 |
/usr | user(历史名称) | 存放大量用户空间程序、库和相关文件 |
用于查看文件的命令
有五个经常用于查看文件内容的基本命令:cat、head、tail、more、less
我们将创建一个名为 numbers.txt 的新文件,并在这个文件中写入从 1 到 100 的数字。每个数字单独占一行。
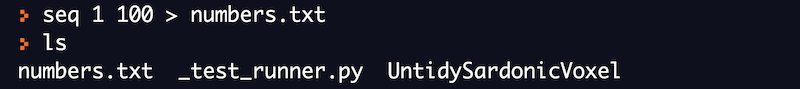
现在不必担心上面的命令。它是一个用于生成数字的高级命令。之后,我们又使用了一个重定向操作符,将这些数字写入文件中。我们将在后面的章节中讨论 I/O 重定向。
cat(concatenate)
cat 命令最简单的用途,是将文件内容打印到输出屏幕上。这个命令非常有用,还可以用于许多其他用途。我们会在后面学习它的其他用法。

你可以尝试运行上面的命令,你会看到从 1 到 100 的数字被打印到屏幕上。你需要向上滚动,才能查看所有数字。
head
head 命令默认显示文件的前 10 行。我们可以加入额外参数,以显示从文件开头算起的任意行数。
在这个例子中,当我们使用 head 命令时,只能看到文件的前 10 行。
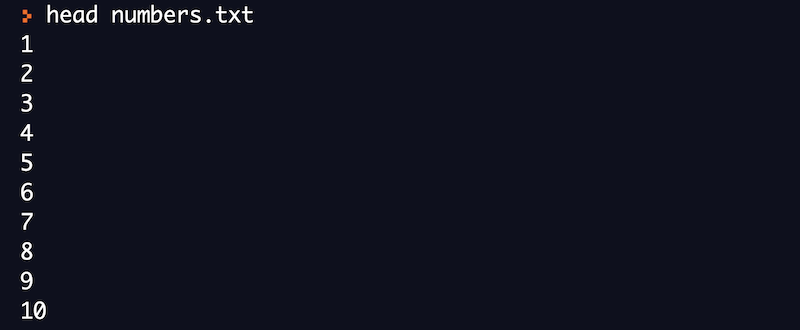
默认情况下,head 命令只会显示前 10 行。如果我们想指定从文件开头查看多少行,可以使用 -n 参数来提供这个数值。
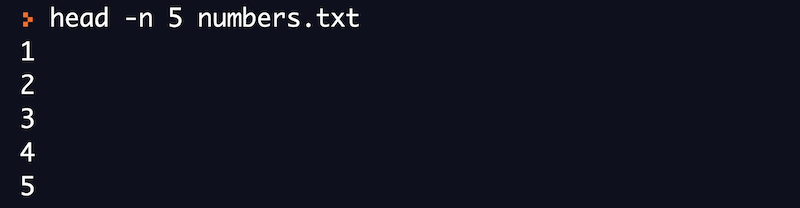
tail
tail 命令默认显示文件的最后 10 行。我们可以加入额外参数,以显示从文件末尾算起的任意行数。
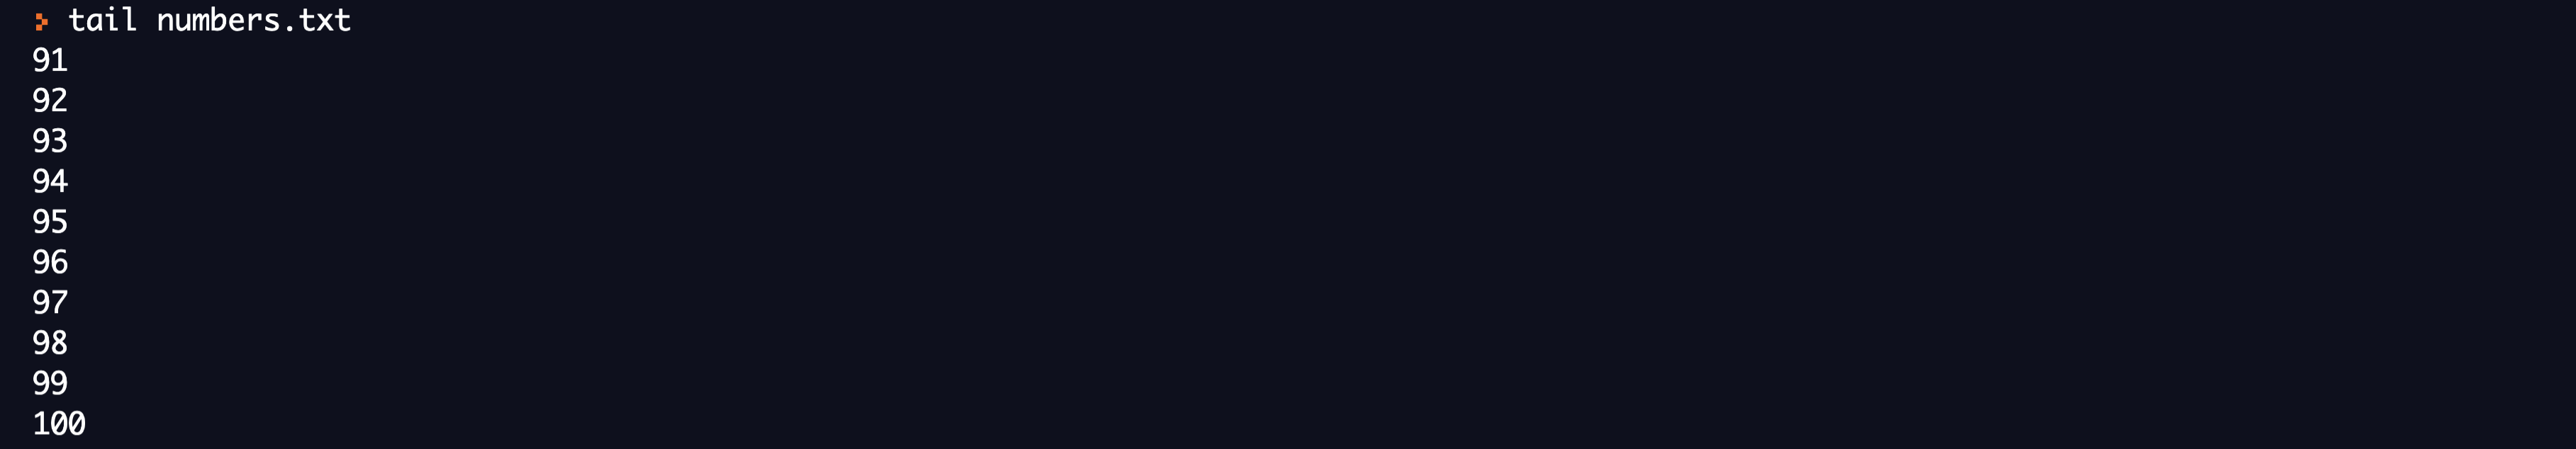
默认情况下,tail 命令只会显示最后 10 行。如果我们想指定从文件末尾查看多少行,可以使用 -n 参数来提供这个数值。

在这个例子中,当我们显式使用 -n 选项配合 tail 命令时,只能看到文件的最后 5 行。
more
more 命令用于显示文件内容或命令输出。当文件很大时,例如日志文件,它会一次显示一个屏幕的内容。它也支持向前导航,以及有限的向后导航。
more就是前面提到的分页显示工具的一种
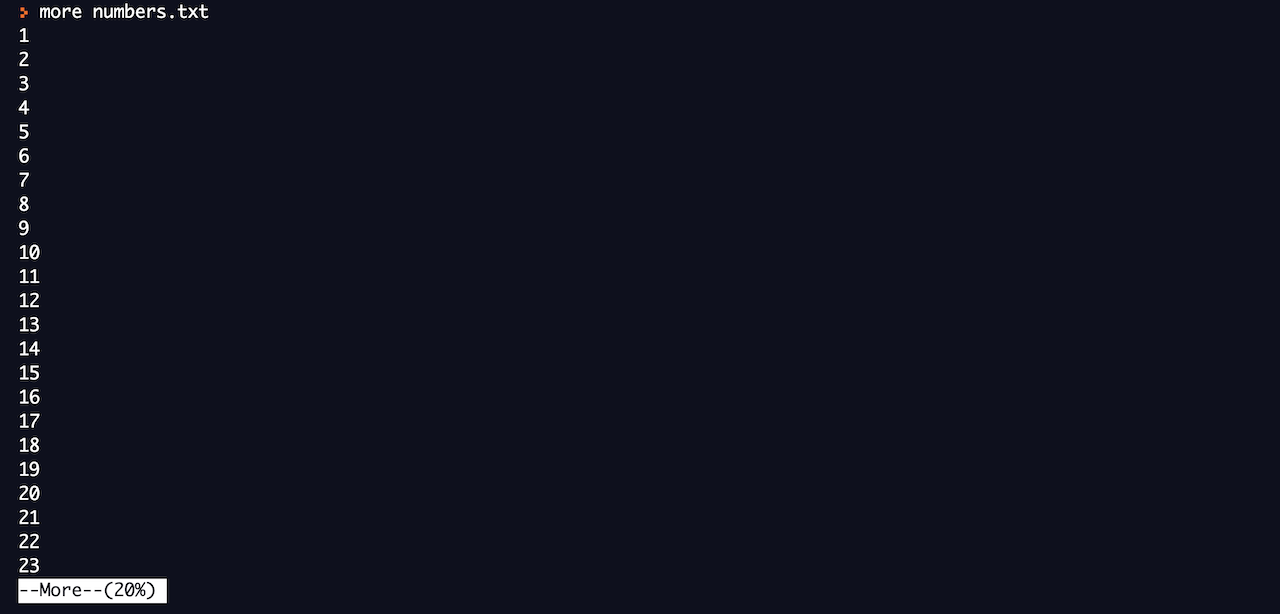
more 命令会显示当前屏幕能够容纳的尽可能多的内容,然后等待用户输入以继续。可以按 Enter 键向前移动一行,也可以按 Space 键向前移动一个屏幕。
less
less 命令是 more 的改进版本。它用于显示文件内容或命令输出,并且一次显示一页。
它既支持向后导航,也支持向前导航,还提供搜索功能。我们可以使用方向键每次向前或向后移动一行。要向前移动一页,可以按 Space;要向后移动一页,可以按键盘上的 b。
你还可以立即跳转到文件的开头或结尾。
文本处理命令
在上一节中,我们学习了如何查看文件内容。在很多情况下,我们会希望执行以下操作:
- 只打印包含某个特定单词的行
- 将文件中的某个特定单词替换为另一个单词
- 按照特定顺序对各行进行排序
有三个经常用于处理文本的基本命令:grep,sed,sort
我们将创建一个名为 numbers.txt 的新文件,并在该文件中写入从 1 到 10 的数字。每个数字单独占一行。
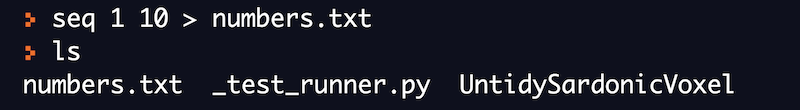
grep(global regular expression print)
grep 命令最简单的用途,是在文本文件中搜索特定单词。它会显示文件中所有包含特定输入内容的行。
我们想要搜索的单词会作为输入提供给 grep 命令。
使用 grep 命令的一般语法:
grep <word_to_search> <file_name>
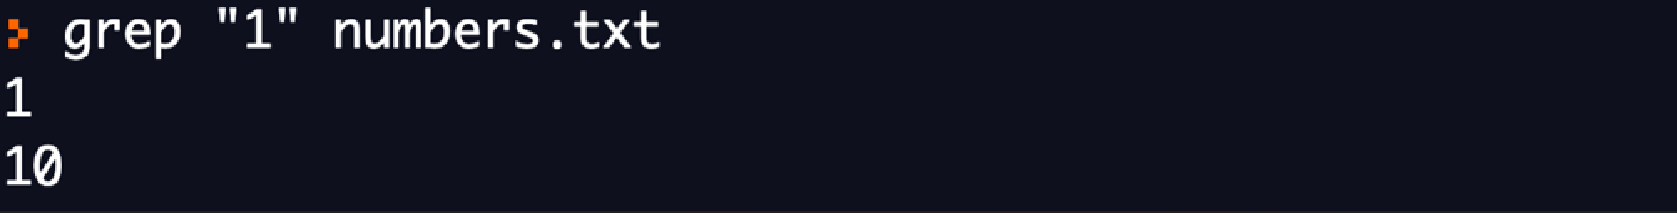
在这个例子中,我们尝试在这个文件中搜索字符串 "1"。grep 命令会输出找到这个字符串的那些行。
sed(stream editor)
sed 命令最简单的用途,是替换文件中的文本。
使用 sed 命令进行替换的一般语法:
sed 's/<text_to_replace>/<replacement_text>/' <file_name>
下面我们尝试使用 sed 命令,将文件中每次出现的 "1" 替换为 "3"。
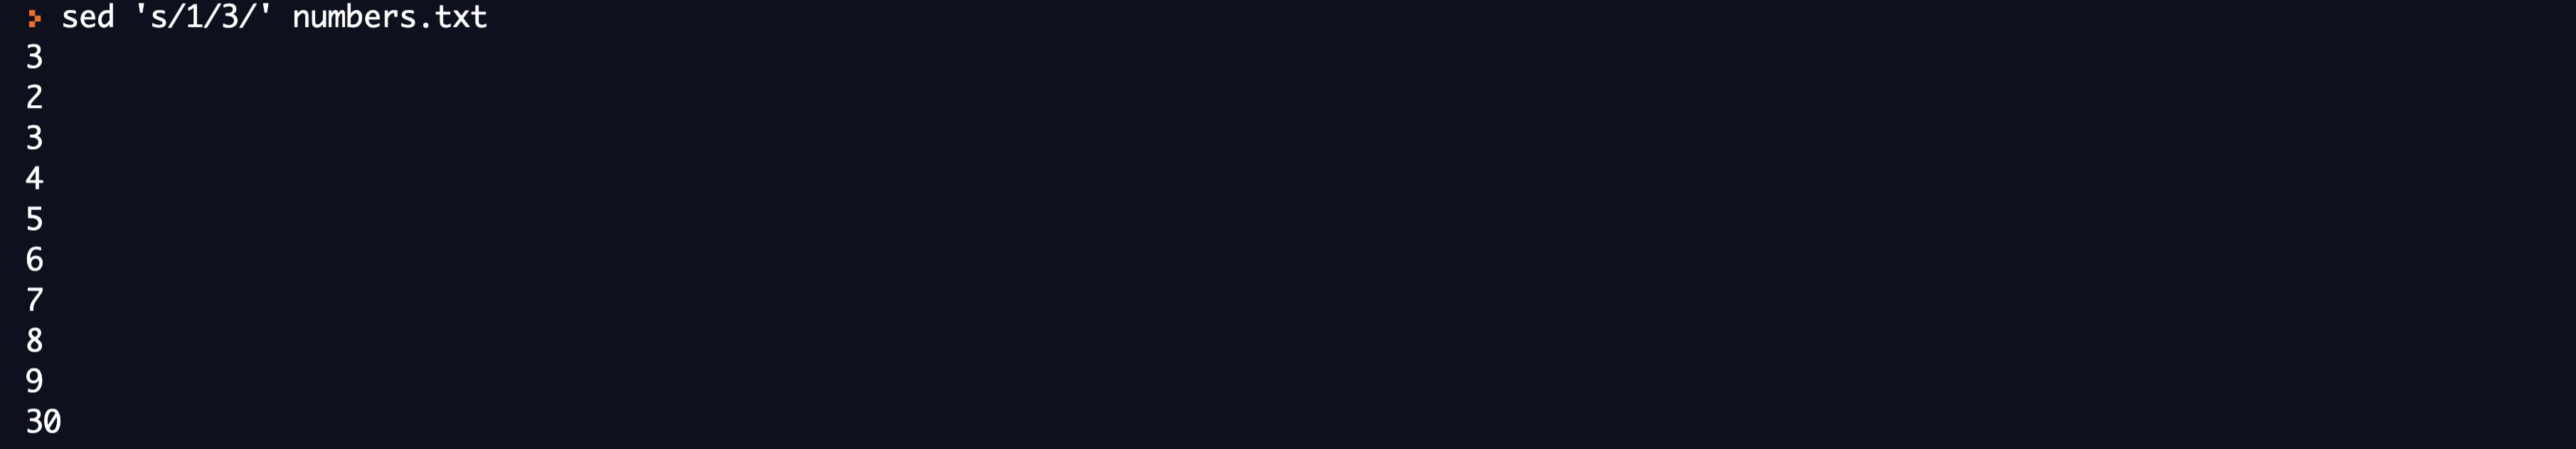
在上面的例子中,文件本身的内容不会发生改变。
如果要让修改直接写回文件,我们必须额外使用 -i 参数,这样修改才会反映到原文件中。
sort
sort 命令可以对作为参数提供给它的输入进行排序。默认情况下,它会按照升序进行排序。
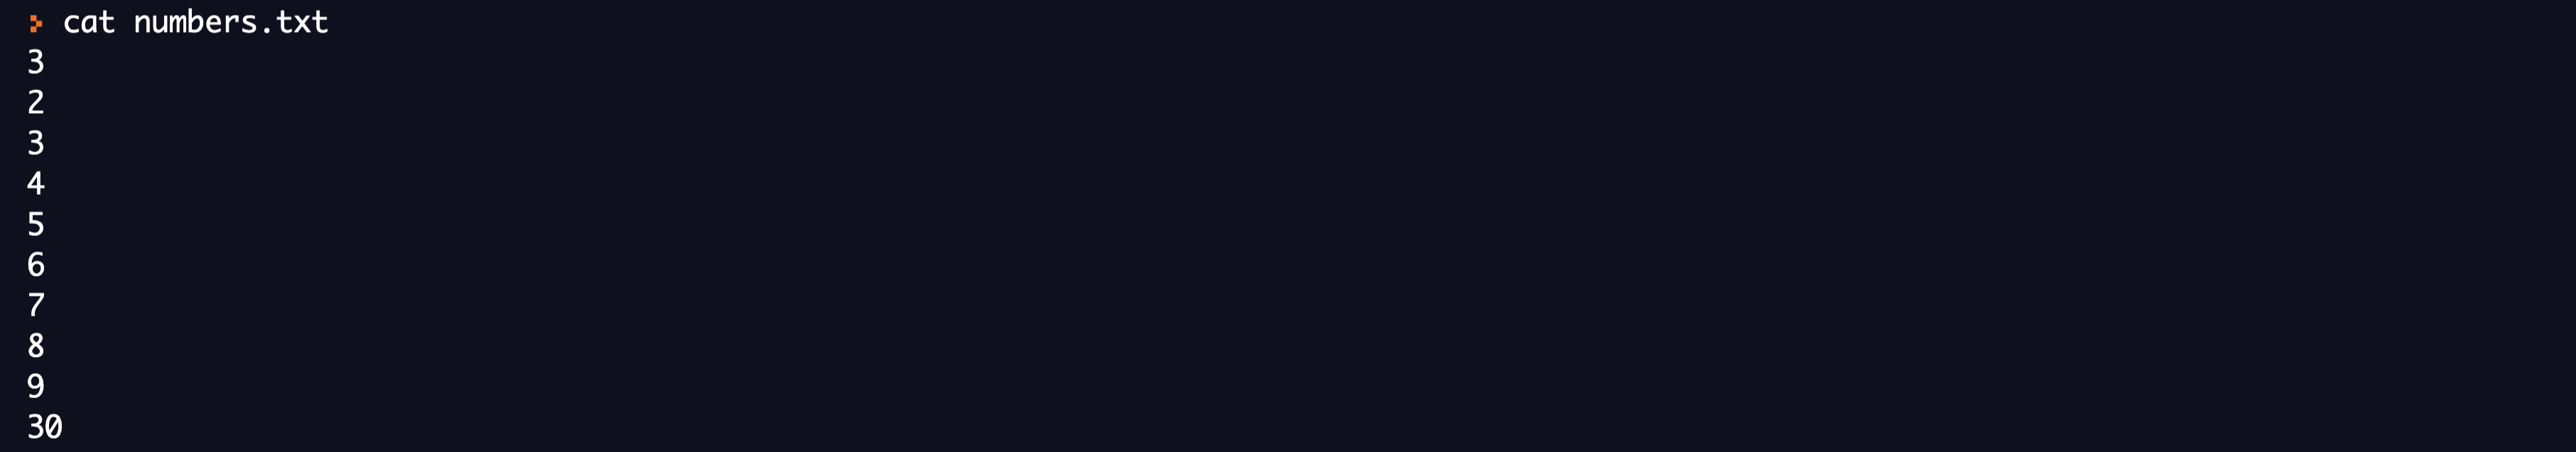
在尝试排序之前,我们先查看一下文件内容。
现在,我们将尝试使用 sort 命令对文件进行排序。sort 命令按照字典序进行排序。
sort默认进行的是“字符串排序”,不是“数学上的数字升序排序”。默认认为每行都是字符串然后依次比较每个字符的大小按ASCII码的顺序。
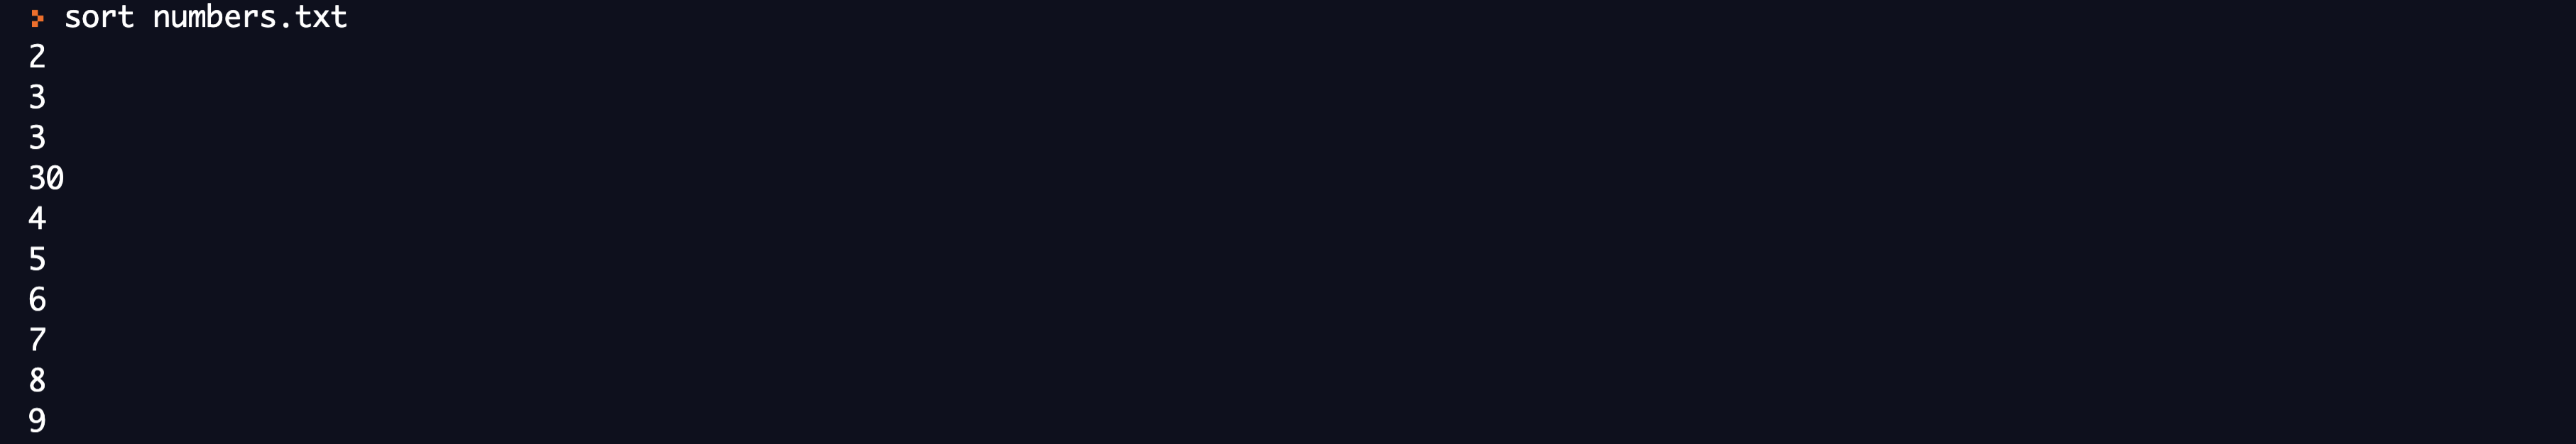
在上面的例子中,文件本身的内容不会发生改变。
I/O 重定向
每个打开的文件都会被分配一个文件描述符(file descriptor)。文件描述符是系统中用于标识打开文件的唯一标识符。系统始终默认打开三个文件:
程序每打开一个文件或输入输出通道,系统都会给它一个数字编号。这个数字编号叫文件描述符。程序启动时,默认已经有 0、1、2 三个文件描述符。
stdin— standard input,标准输入,这里通常指键盘stdout— standard output,标准输出,这里通常指屏幕stderr— standard error,标准错误,即输出到屏幕上的错误信息
这些文件都可以被重定向。
Linux 中“一切皆文件”(Everything is a file):
https://unix.stackexchange.com/questions/225537/everything-is-a-file
Linux 将普通文件、目录、设备、终端、管道等资源统一抽象为“文件”,程序可以通过类似的读写接口访问它们。很多操作都可以被抽象成对广义文件的
open,read,write,close。前文的stdin,stdout,stderr就被抽象为文件。
到目前为止,我们一直把所有输出显示在屏幕上,而屏幕就是标准输出。我们可以使用一些特殊操作符,将命令的输出重定向到文件中,甚至将其重定向成其他命令的输入。I/O 重定向是一项非常强大的功能。
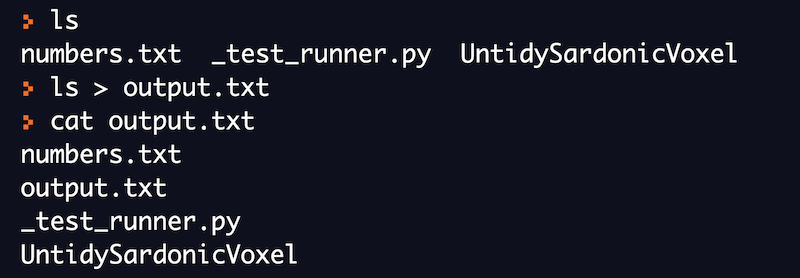
在下面的例子中,我们使用 > 操作符,将 ls 命令的输出重定向到 output.txt 文件中。
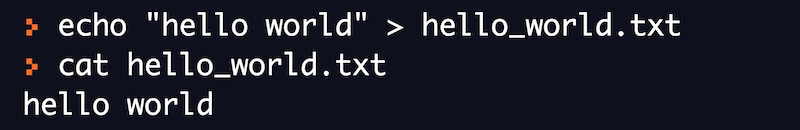
在下面的例子中,我们将 echo 命令的输出重定向到了一个文件中。
我们也可以将一个命令的输出重定向为另一个命令的输入。
这可以借助管道(pipe)来实现。
在下面的例子中,我们使用管道操作符 |,把 cat 命令的输出作为输入传递给 grep 命令。

uniq(unique)
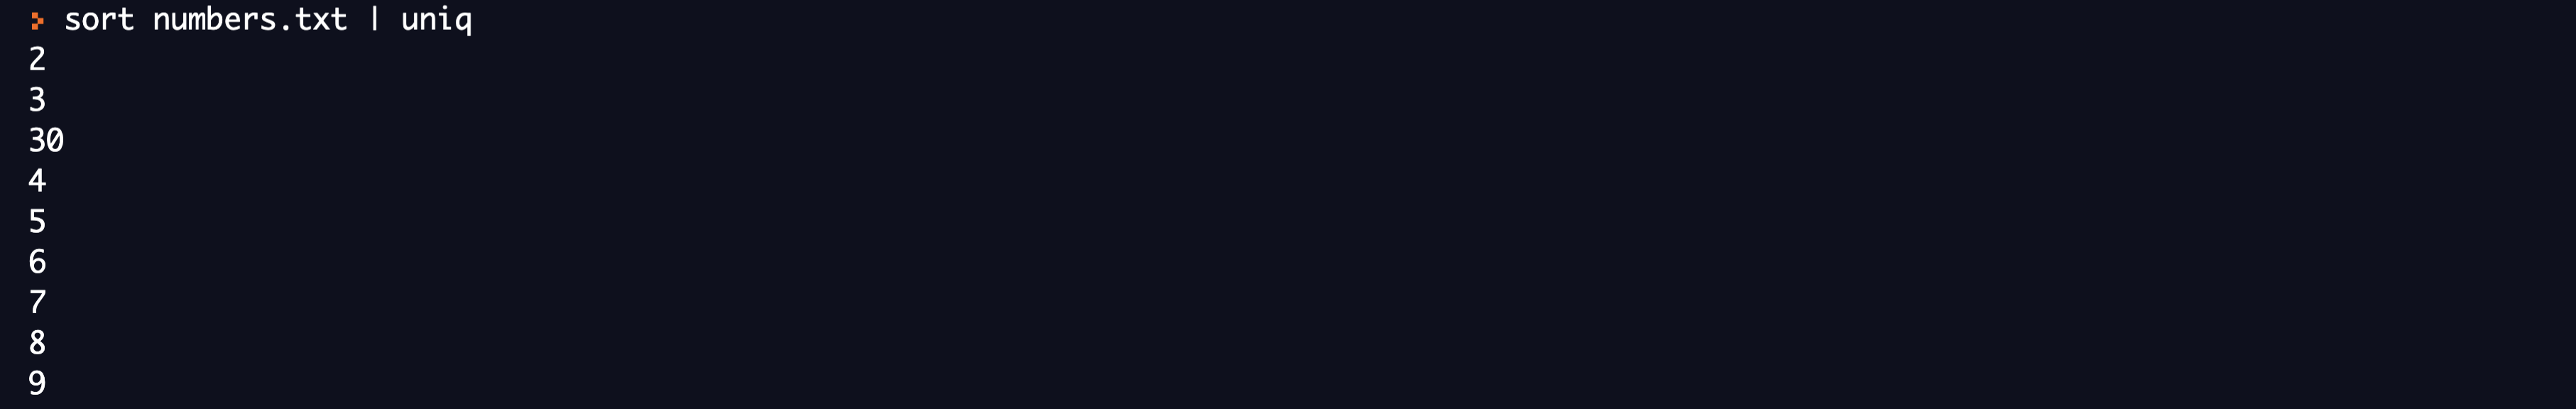
在下面的例子中,我们使用管道操作符 |,把 sort 命令的输出作为输入传递给 uniq 命令。
uniq 命令只会打印输入中的唯一数字。
I/O 重定向: https://tldp.org/LDP/abs/html/io-redirection.html
Linux 服务器管理
多用户操作系统
如果一个操作系统允许多个用户使用同一台计算机,并且不会相互影响彼此的文件和个人设置,那么这个操作系统就可以被称为多用户操作系统。
基于 Linux 的操作系统本质上就是多用户操作系统,因为它允许多个用户同时访问系统。一台典型的计算机通常只有一个键盘和一台显示器,但如果计算机连接到了网络,多个用户就可以通过 SSH 登录到这台计算机。我们会在后面进一步介绍 SSH。
作为服务器管理员,我们大多数时候需要管理的 Linux 服务器,在物理位置上都距离我们非常远。我们可以借助 SSH 这类远程登录方式连接到这些服务器。
由于 Linux 支持多个用户,因此我们需要一种机制来让不同用户彼此隔离并受到保护。一个用户不应该能够访问或修改其他用户的文件。
用户/用户组管理
Linux 中的每个用户都有一个与之关联的用户 ID,称为 UID(User ID,用户标识符)。每个用户还会关联一个主目录(home directory)和一个登录 Shell(login shell)。**用户组(group)**是一个或多个用户的集合。通过用户组,可以更方便地为一组用户共享和管理权限。每个用户组都有一个与之关联的组 ID,称为 GID(Group ID,组标识符)。
id
id 命令可以用来查看与某个用户关联的 UID 和 GID。它还会列出该用户所属的用户组。
与 root 用户关联的 UID 和 GID 都是 0。
在 Linux 中,查看当前用户是谁,一个很方便的方法是使用 whoami 命令。
root 用户,也称为超级用户(superuser),是系统中权限最高的用户,可以不受限制地访问系统中的所有资源。它的 UID 为 0。
与用户/用户组相关的重要文件
| 文件 | 作用 |
|---|---|
/etc/passwd | 记录用户名、UID、GID、主目录和登录 Shell 等账户信息 |
/etc/shadow | 存储用户密码的哈希值及密码有效期等安全信息 |
/etc/group | 记录用户组名称、GID及组成员信息 |
进一步理解 linux 的权限机制可以参考下面的链接:
https://tldp.org/LDP/lame/LAME/linux-admin-made-easy/shadow-file-formats.html https://tldp.org/HOWTO/User-Authentication-HOWTO/x71.html
管理用户的重要命令
Linux 中经常用于管理用户/用户组的一些命令如下:
useradd— user add,创建一个新用户passwd— password,为用户添加或修改密码usermod— user modify,修改用户属性userdel— user delete,删除用户
useradd(user add)
useradd 命令用于在 Linux 中添加一个新用户。
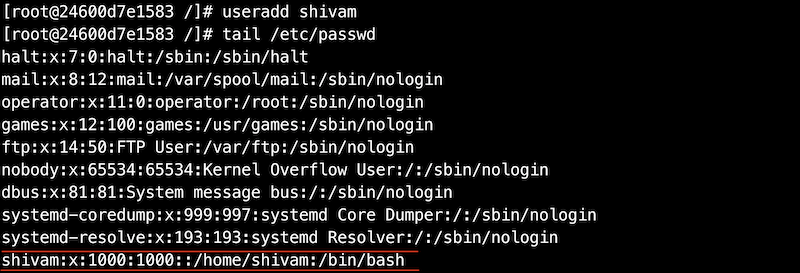
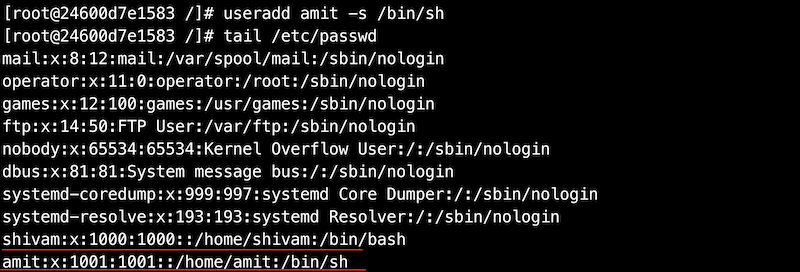
我们将创建一个新用户 shivam。然后通过查看 /etc/passwd 文件的末尾内容,验证该用户是否已经成功创建。
新创建用户的 UID 和 GID 都是 1000。分配给该用户的主目录(home directory)是 /home/shivam,登录 Shell(login shell)是 /bin/bash。
需要注意的是,用户的主目录和登录 Shell 之后都可以修改。
如果我们没有为主目录或登录 Shell 等属性指定任何值,系统就会为用户分配默认值。
在创建新用户时,我们也可以覆盖这些默认值,手动指定相应属性。
passwd(password)
passwd 命令用于为用户创建或修改密码。
在上面的例子中,我们创建用户 shivam 和 amit 时,都没有为他们设置密码。
在 /etc/shadow 中,如果一个账户对应的字段中出现 !!,表示该用户账户已经创建,但尚未设置密码。
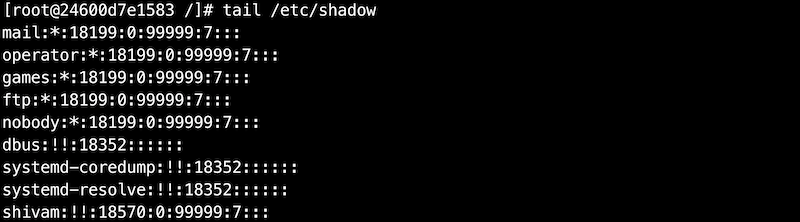
现在我们尝试为用户 shivam 创建一个密码。
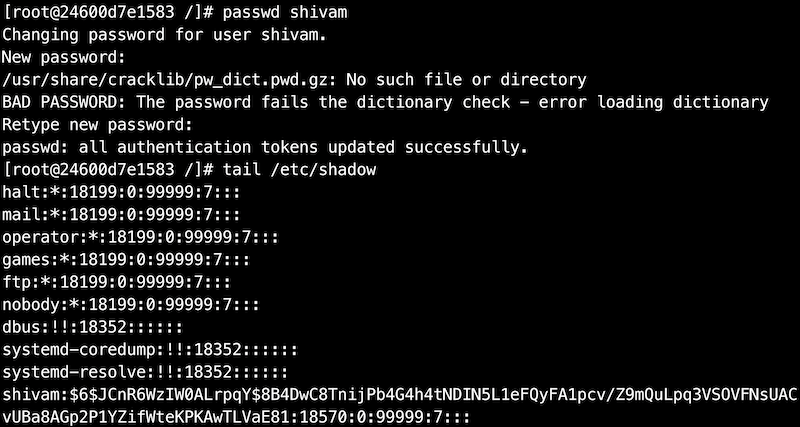
请记住这个密码,因为在后面的示例中我们还会用到它。
另外,现在我们也来修改 root 用户的密码。
当我们从普通用户切换到 root 用户时,系统会要求输入密码。同样,当你直接使用 root 用户登录时,也会要求输入密码。
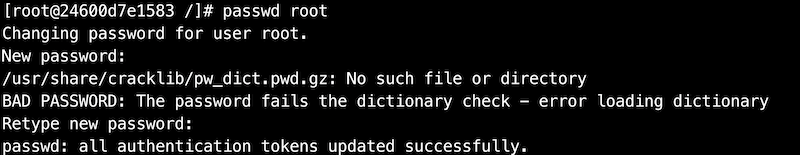
图上密码强度检验工具的字典不存在所以报错,正常情况下不会报这种错。
usermod(user modify)
usermod 命令用于修改用户的属性,例如主目录或 Shell。
下面我们尝试把用户 amit 的登录 Shell 修改为 /bin/bash。
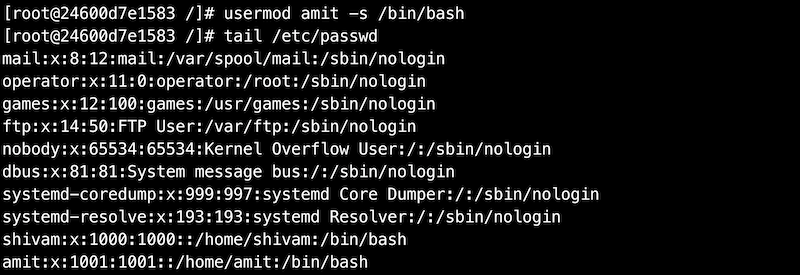
类似地,你还可以修改用户的许多其他属性。
可以运行:
usermod -h
查看可以修改的属性列表。
userdel(user delete)
userdel 命令用于删除 Linux 中的用户。
删除一个用户后,与该用户相关的信息也会被删除。
下面我们尝试删除用户 amit。删除之后,你将无法再在 /etc/passwd 或 /etc/shadow 文件中找到该用户对应的条目。
管理用户组的重要命令
用于管理用户组的命令,与用于管理用户的命令非常相似。由于这些命令的用法比较接近,这里不再逐一详细解释。你可以尝试在自己的系统上运行这些命令。
| 命令 | 说明 |
|---|---|
groupadd <group_name> | group add,创建一个新用户组 |
groupmod <group_name> | group modify,修改用户组的属性 |
groupdel <group_name> | group delete,删除一个用户组 |
gpasswd <group_name> | group password,修改用户组密码 |
groupmod一般用于改用户组名和 GID 用户组密码用的很少了,有newgrp命令可以临时将用户添加入该组,此时需要输入组密码。
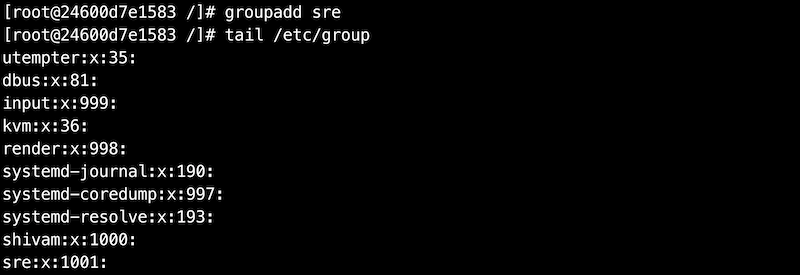
现在,我们将尝试把用户 shivam 添加到上面创建的用户组中。
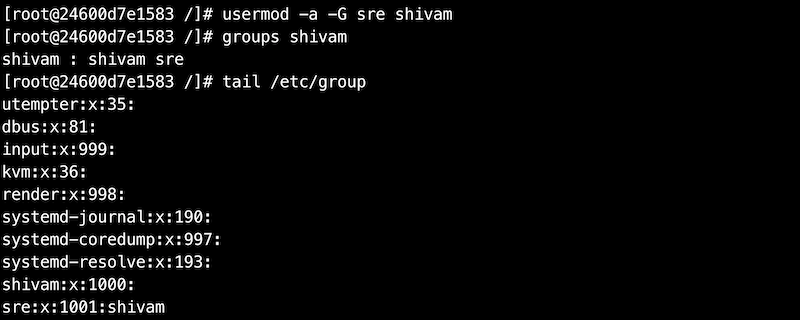
成为超级用户
在运行下面这些命令之前,请确保你已经按照上一节介绍的方法,使用 passwd 命令为用户 shivam 和用户 root 设置了密码。
su(switch user) 命令可以用于在 Linux 中切换用户。现在我们尝试切换到用户 shivam。

现在我们尝试打开 /etc/shadow 文件。

操作系统不允许用户 shivam 读取 /etc/shadow 文件的内容。这个文件在 Linux 中非常重要,用于存储用户密码相关的信息。只有 root 用户或具有超级用户权限的用户才能访问这个文件。
sudo 命令允许用户以 root 用户的安全权限来运行命令。
请记住,root 用户拥有系统上的全部权限。
我们也可以使用 su 命令切换到 root 用户,然后再打开上面的文件,但这样做需要输入 root 用户的密码。
在大多数现代操作系统中,更常见也更推荐的另一种方式,是使用 sudo(superuser do/substitute user do) 命令来获得超级用户权限。采用这种方式时,用户通常需要输入自己的密码,并且需要属于拥有 sudo 权限的用户组。
如何给其他用户提供超级用户权限?
我们先使用 su 命令切换到 root 用户。需要注意的是,执行下面的命令时需要输入 root 用户的密码。

如果你忘了给 root 用户设置密码,可以输入exit
这样你就会返回之前的 root 用户环境。然后使用 passwd 命令设置密码。
/etc/sudoers 文件用于保存哪些用户可以调用 sudo,以及相关的权限规则。
在 Red Hat 系列操作系统中,这个文件所依赖的 sudo 工具在某些精简环境里可能默认没有安装,因此需要先安装 sudo。
尝试打开系统中的 /etc/sudoers 文件。这个文件包含很多信息,用来保存用户运行 sudo 命令时必须遵循的规则。
例如,root 用户被允许在任何地方运行任何命令。
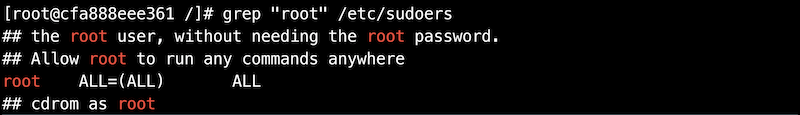
一种比较简单的给用户提供 root 权限的方法,是把用户加入一个被允许执行所有命令的用户组。
在 Red Hat Linux 中,wheel 就是这样一个常见的特权用户组。
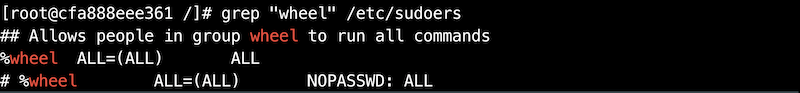
这里的
%wheel ALL=(ALL) ALL的意思是wheel这个组中的用户可以使用sudo命令临时用任何用户身份做任何事。所以sudo也可以被理解成 substitute user do —— 用另一个用户身份代替当前用户去执行命令。不加-u参数时,默认使用root用户。
现在我们把用户 shivam 加入这个组,这样它也可以获得 sudo 权限。

现在我们切换回用户 shivam,再次尝试访问 /etc/shadow 文件。
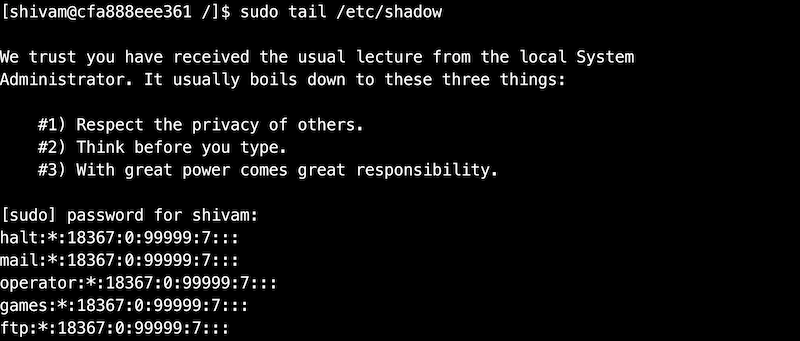
由于这个文件只能由具有相应高权限的用户访问,因此我们需要在命令前加上 sudo。
我们之前已经把用户 shivam 加入了 wheel 组,因此它已经获得了使用 sudo 的权限。
sudo的验证逻辑是先判断当前用户是不是本人,然后再按照权限组规则开发对应替代用户的权限,所以sudo时输入的是当前用户的密码。而su则是输入目标用户的密码。